Las personas suelen notar cuándo pisan terreno desconocido y su conocimiento deja de bastar. La inteligencia artificial no tiene ese instinto: aprende con datos seleccionados y puede quedar desorientada cuando el mundo es distinto al del entrenamiento. El proyecto europeo E-pi enseñó a los algoritmos a reconocer su propia ignorancia y lo puso a prueba donde un error puede salir más caro: en los coches autónomos. Al final podrás comprobar cómo gestionas tú mismo la incertidumbre.
La inteligencia artificial llega hoy a casi todas partes. Impulsa la economía y transforma nuestros hogares, colegios y puestos de trabajo. Sin embargo, tiene un punto débil del que se habla menos que de sus éxitos. Un modelo aprende con un conjunto concreto de datos y luego debe funcionar en un mundo que no siempre se parece a lo que vio durante el entrenamiento. Es justo entonces cuando empiezan los problemas.
De este problema se ocupó el proyecto E-pi, financiado por la Unión Europea y coordinado por la Oxford Brookes University en el Reino Unido. Su equipo trabajó durante cinco años en la llamada inteligencia artificial epistémica, es decir, una IA que afronta mejor la incertidumbre y puede hacer predicciones incluso en situaciones distintas a las de los datos de entrenamiento.
La palabra epistémica procede de la epistemología, la rama de la filosofía que estudia el conocimiento. De ese campo surge una capacidad del todo natural para el ser humano: darse cuenta de que lo que sabemos no basta en una situación dada. Es uno de los elementos básicos de la inteligencia humana.
La máquina no puede hacerlo por sí sola. En su caso, reconocer la propia ignorancia debe apoyarse en marcos teóricos y matemáticos. Dicho de otro modo, la sensación de no estar ya seguro hay que escribirla, literalmente, en la construcción del algoritmo.
El coordinador del proyecto, Fabio Cuzzolin, señala que los algoritmos clásicos de aprendizaje automático se centran en explicar un conjunto de datos de entrenamiento relativamente pequeño, y no todos los datos que pueden aparecer en la realidad. La consecuencia es fácil de prever. «Con los modelos tradicionales de IA aparecen dificultades para realizar predicciones fiables cuando las distribuciones de probabilidad que generan los datos difieren de las utilizadas durante el entrenamiento», explica el investigador.
En pocas palabras, un modelo que conoce bien solo un fragmento del mundo puede perderse cuando se topa con algo que queda fuera de él. El consorcio de E-pi concluyó que la teoría de la incertidumbre de segundo orden es el cimiento más prometedor para una solución. Las ponencias del proyecto han tenido una acogida entusiasta en congresos especializados, y Cuzzolin ha sido seleccionado para participar en varias propuestas relacionadas con el programa Horizonte Europa. El trabajo del equipo debe ayudar a construir un ecosistema internacional de IA epistémica.
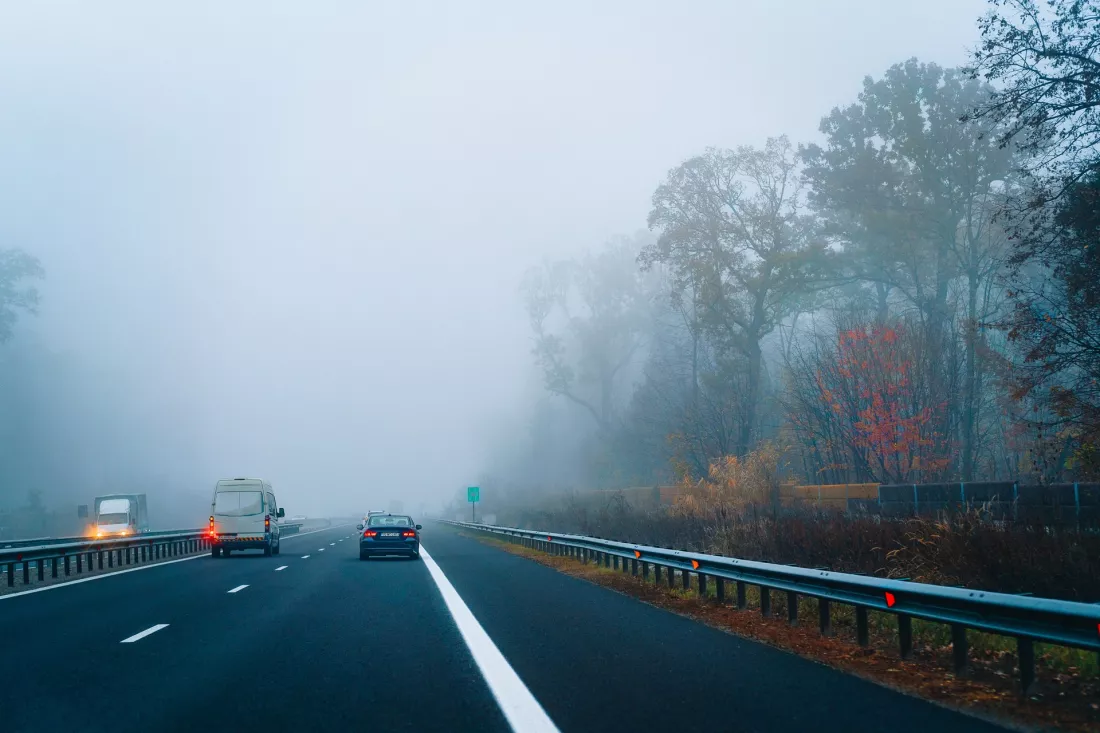
¿Dónde conviene más probar una inteligencia artificial que debe afrontar lo impredecible? Los investigadores eligieron los vehículos autónomos. En la carretera una situación puede escapar de pronto a cualquier esquema, por el comportamiento de los peatones, el clima extremo o un trazado inusual. Los errores de los sistemas actuales pueden ser muy costosos y, en el peor de los casos, provocar lesiones mortales.
El equipo utilizó el conjunto de datos ROAD, dedicado al reconocimiento de incidentes en carretera por parte de vehículos autónomos. Sirvió tanto para entrenar el modelo como para probar los nuevos detectores de objetos epistémicos. ROAD se amplía de forma continua y contiene grabaciones de Europa, Norteamérica, Dubái y Abu Dabi, lo que lo ha convertido en un recurso verdaderamente mundial.
Unos coches sin conductor más seguros son solo uno de los objetivos. De la misma lógica pueden beneficiarse también otros campos:
La fusión nuclear es un ejemplo especialmente exigente. «Estamos trabajando en el desarrollo de modelos de operadores neuronales que tengan en cuenta la incertidumbre, con el fin de predecir cómo fluirá el plasma de fusión dentro de un tokamak y qué zonas de los reactores se verán más afectadas por él», dice Cuzzolin. Esos modelos deben predecir el flujo del plasma dentro de un tokamak, es decir, de un reactor, e indicar qué zonas de este quedarán más expuestas. También aquí se trata de lo mismo: el modelo no solo debe dar un resultado, sino tener en cuenta con honestidad cuán seguro está de él.
Otra línea de trabajo afecta a la IA generativa. «Se sabe que los grandes modelos de lenguaje (LLM, por sus siglas en inglés) de última generación generan afirmaciones falsas», admite Cuzzolin. En su opinión, la salida pueden ser modelos construidos según un nuevo paradigma: «Los LLM epistémicos pueden mitigar de forma significativa el exceso de confianza de esos modelos».
También hay planes de soluciones relacionadas con la teoría de la mente y de sistemas que evolucionan gracias al aprendizaje continuo. El denominador común sigue siendo el mismo: la inteligencia artificial no solo debe responder, sino también saber cuándo su respuesta se apoya en bases frágiles.
El proyecto E-pi, cuyo coste total fue de unos 3 millones de euros, contribuyó al desarrollo de vehículos autónomos y robots más seguros y de una inteligencia artificial generativa que no alucina. También creó una red dinámica de expertos en aprendizaje automático. Sus autores sostienen que la IA epistémica puede cambiar el mundo y nuestra vida cotidiana. Y todo empieza con una capacidad muy humana: admitir que no se sabe algo.
5 preguntas · un minuto


 English
 Čeština
 Deutsch
 Español
 Français
 Magyar
 Italiano
 Polski
 Português
 Русский
 Slovenčina
 Türkçe
 Українська
 العربية
 中文